
추출
브로슈어의 사진이 필요한데, PDF에서는 마우스 오른쪽 버튼을 눌러도 "이미지 저장"이 되지 않아요. 추출은 파일 안에 있는 내용을 꺼내 별도의 파일로 저장하는 기능이에요. 모든 이미지, 선택한 페이지, 텍스트, 링크를 추출할 수 있어요.
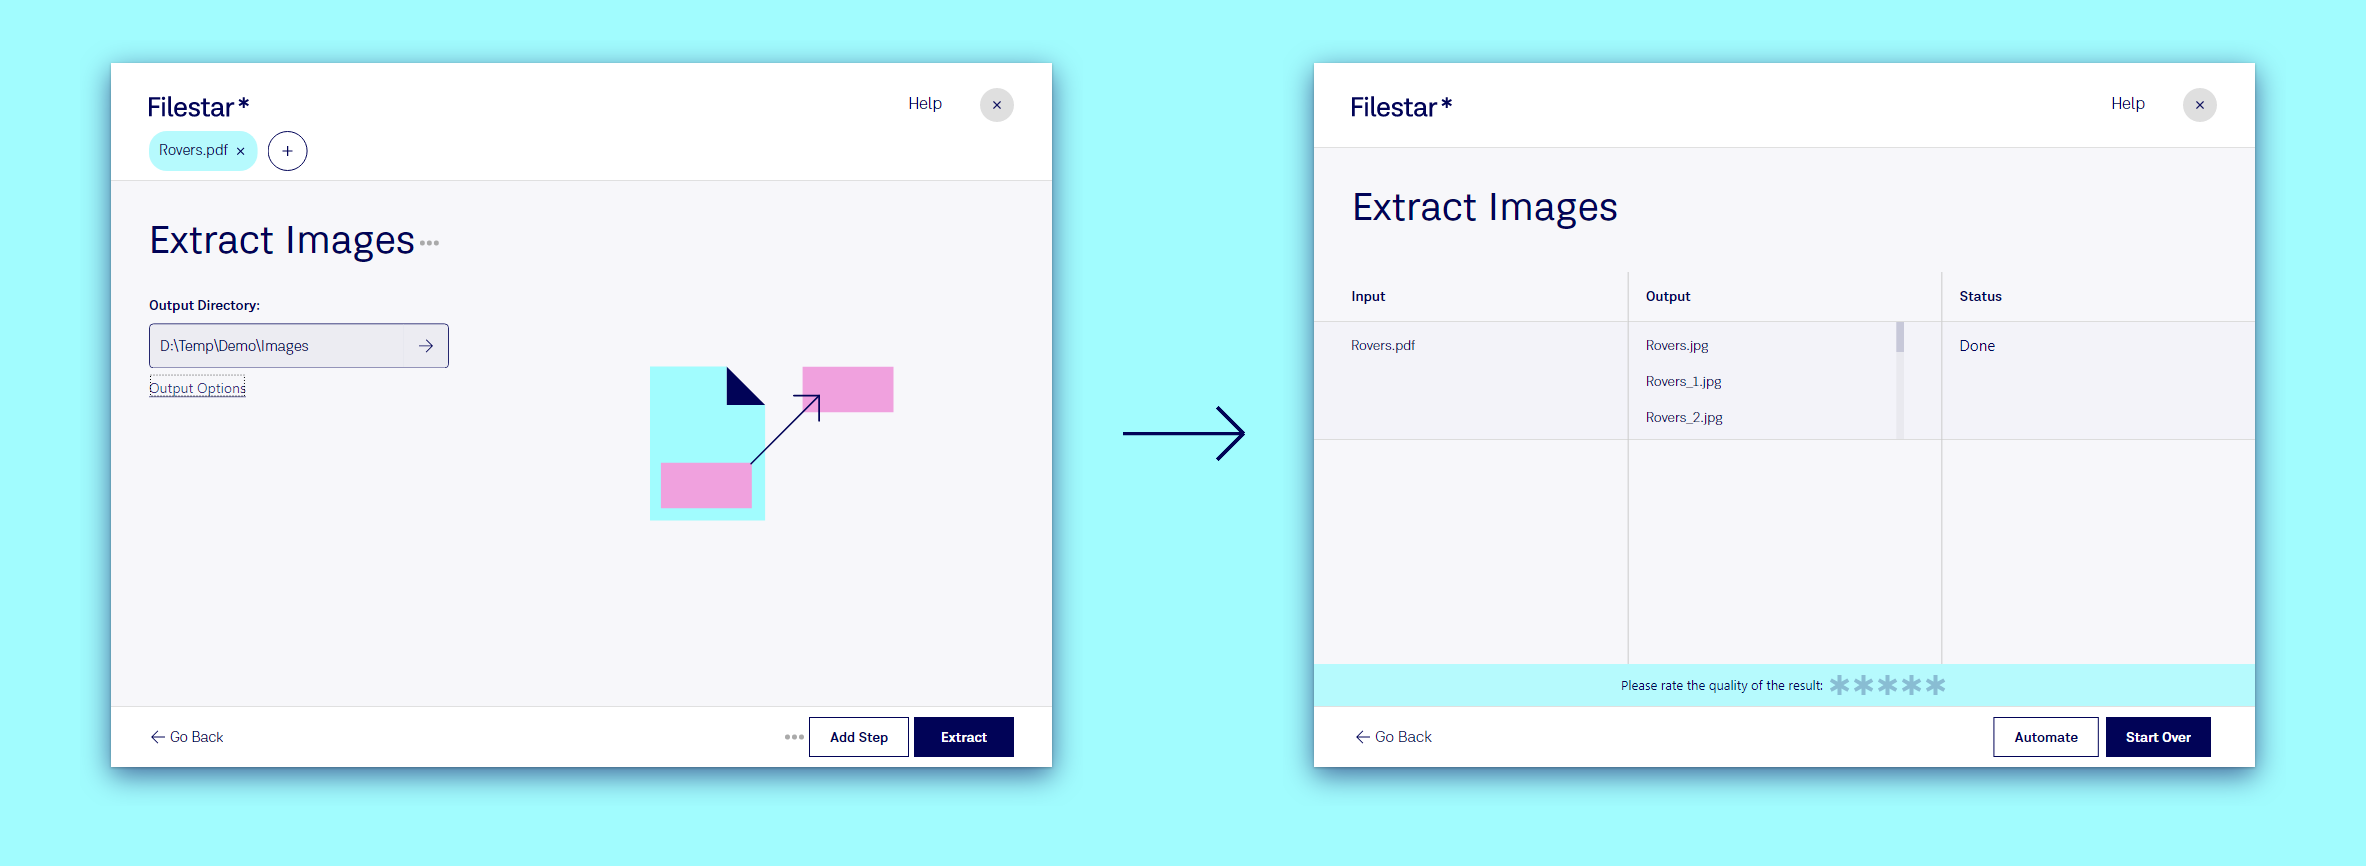
PDF에서 이미지 추출하기
- PDF를 Filestar에 끌어다 놓아요.
extract images를 입력하고 추천 항목을 선택해요.- 출력 디렉터리에서 저장할 위치를 선택해요. 전용 폴더를 만들면 깔끔하게 정리할 수 있어요.
- 추출을 클릭해요.
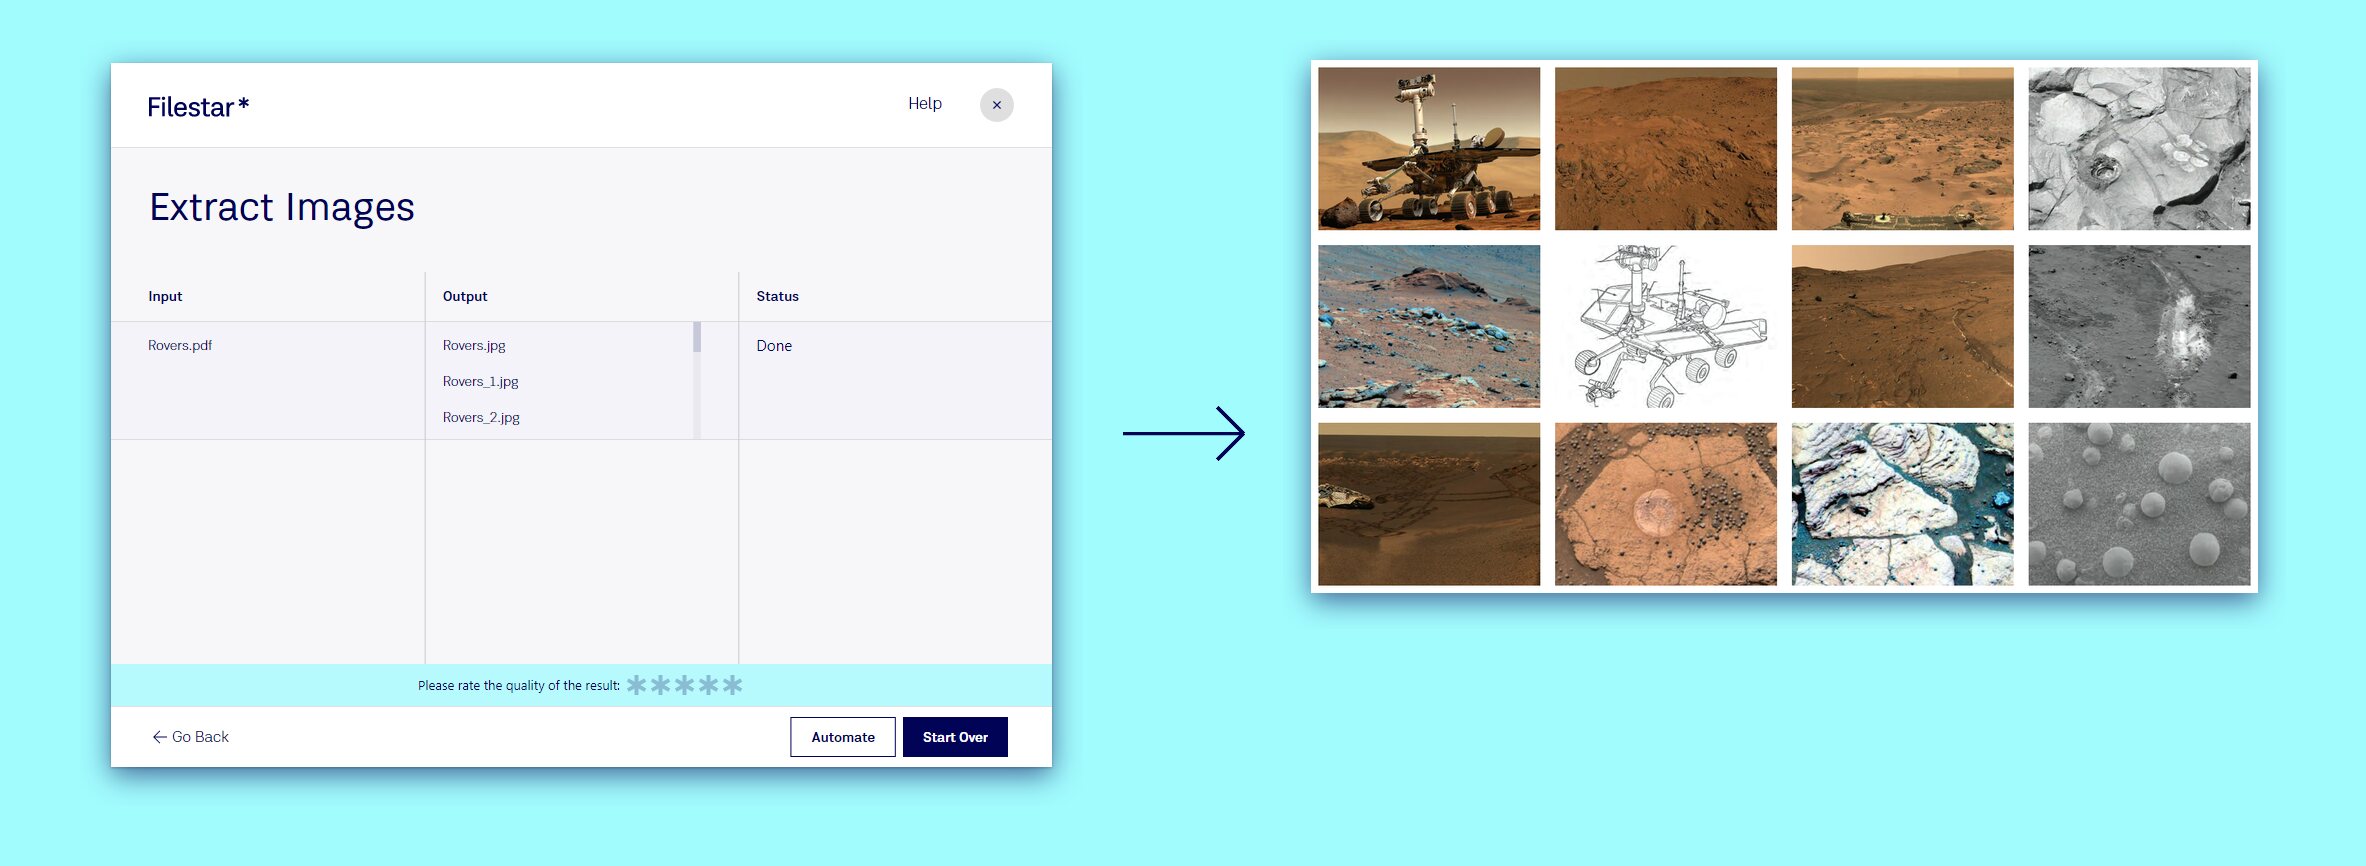
Filestar로 화성 탐사 로버에 관한 20페이지짜리 브로슈어에서 이미지 32개를 원본 품질 그대로 추출했어요. 바로 사용할 수 있어요:
그 밖에 추출할 수 있는 것
- PDF의 페이지 중 필요한 것만 남기기: PDF에서 페이지 추출하기
- Word 문서의 이미지: DOCX에서 이미지 추출하기
- PDF나 문서의 링크: PDF에서 링크 추출하기
- 카메라와 날짜 같은 사진 정보: JPG에서 EXIF 추출하기
- zip 같은 압축 파일 안의 파일을 내부 폴더 구조 그대로 추출하기: Bulk Renaming의
<ArchivePath>태그를 참고해요.
파일을 끌어다 놓고 extract를 입력하면 Filestar로 무엇을 추출할 수 있는지 확인할 수 있어요.
더 활용하기
- 추출하면서 변환하기: 이미지를 JPG로 변환하거나 크기를 조절하는 단계를 추가해요. Recipes를 참고해요.
- 분할이 필요한가요? 모든 페이지를 각각 별도의 파일로 저장하려면 분할을 참고해요.
직접 해 보세요: PDF에서 이미지 추출하기.